rocksdb checkpoint 空间放大的极致优化
如果想把一个运行中的rocksdb从快设备拷贝到慢设备上,一般需要比较长的时间,在rocksdb的CreateCheckpointImpl里,这里有个非常大的锁,即db_->DisableFileDeletions();,在我们的场景里,这是几乎无法接受的,带来了非常大的空间放大。如果我们单纯是给一个version ref一下再拷贝,那么也是很大粒度的锁,这里介绍一种sst粒度的locker方案,完全绕开了rocksdb,并在线上长期(>4年)稳定运行。
步骤一,按通常的checkpoint步骤,获取db->mutex_,把memtable flush下去,并拿到最新version的所有live file,把MANIFEST拷贝出来,MANIFEST不大,拷贝很快
步骤二,重新open一下所有sst,即文件引用技术+1,并解锁db->mutex_,由于rocksdb在posix系统上删除文件都是调用unlink,所以接下来所有compaction里,rocksdb自己以为删除掉了那些旧sst,而实际那些旧sst还在
步骤三,组织一个queue,把那些sst加入到queue里,重写env层的DeleteFile,当rocksdb调用DeleteFile时,判断这个file是否是我们open过的sst,如果是,那么意味着rocksdb想在正常流程中删除这个sst,而此时这个sst被我们hold住了,此时把这个sst在queue里的优先级提高,让这个sst被优先拷贝出去
步骤四,所有sst拷贝完成,落一个类似write.done的文件
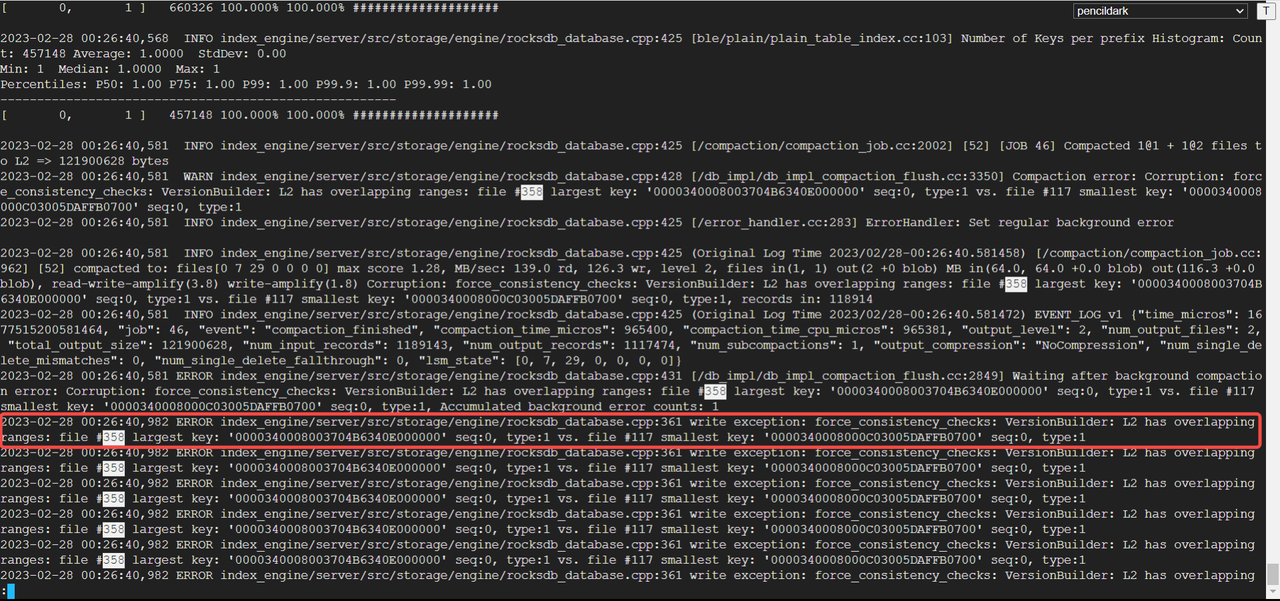
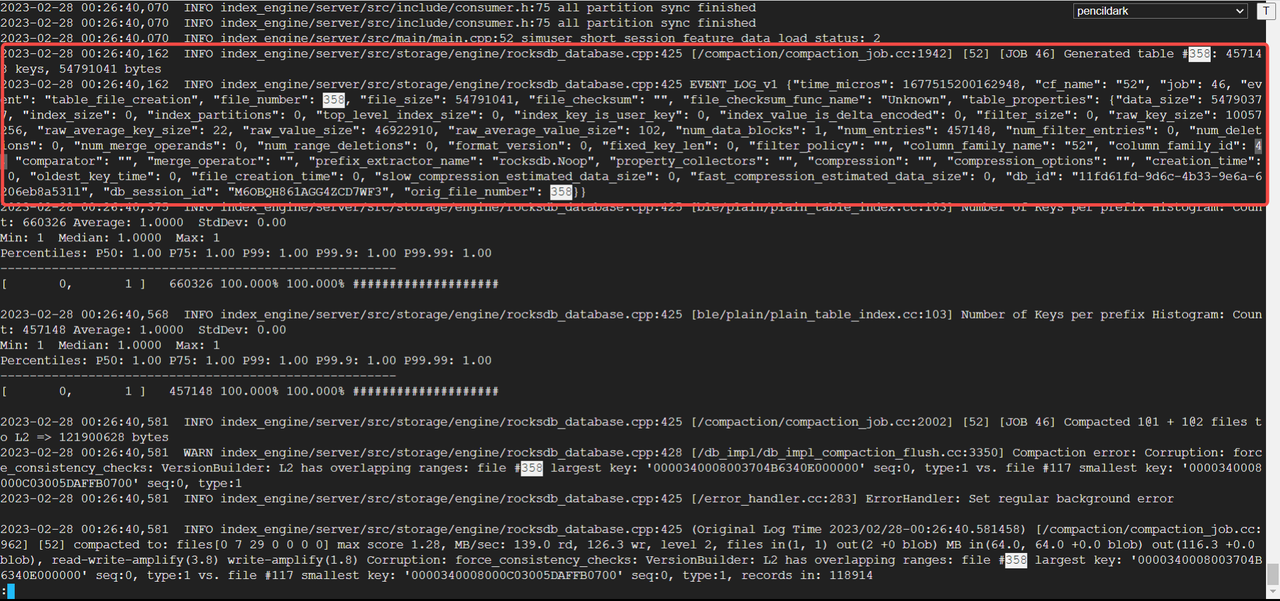 ,发现某个compaction任务刚结束,生成了358.sst,随后在一致性检查里报错compaction error.
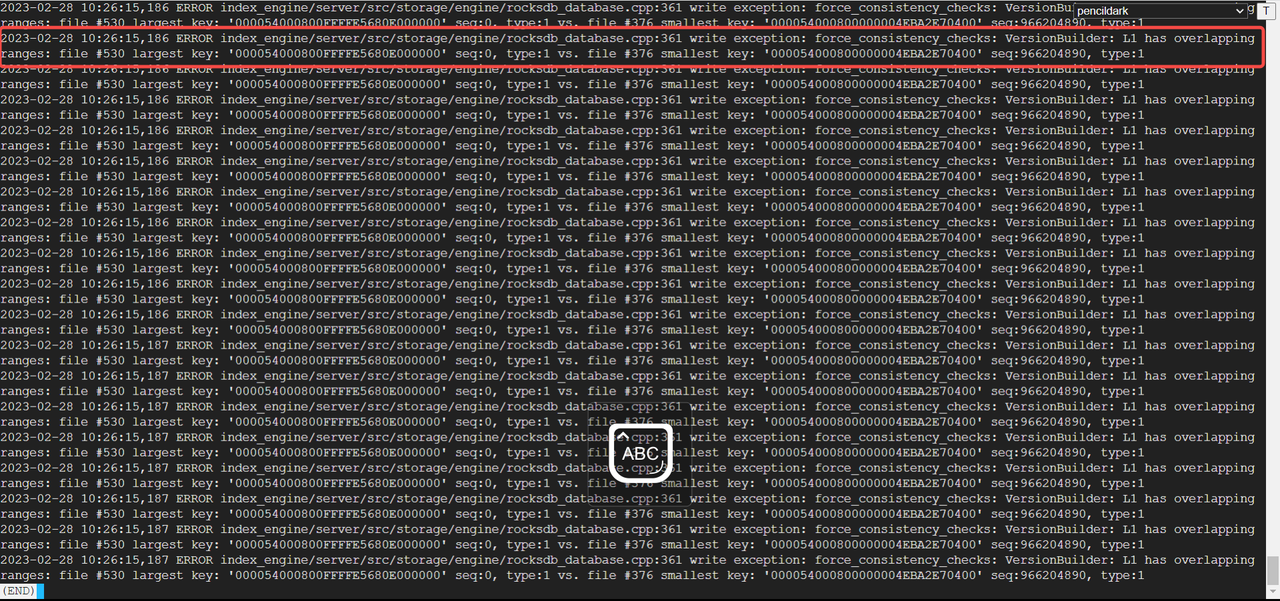 ,
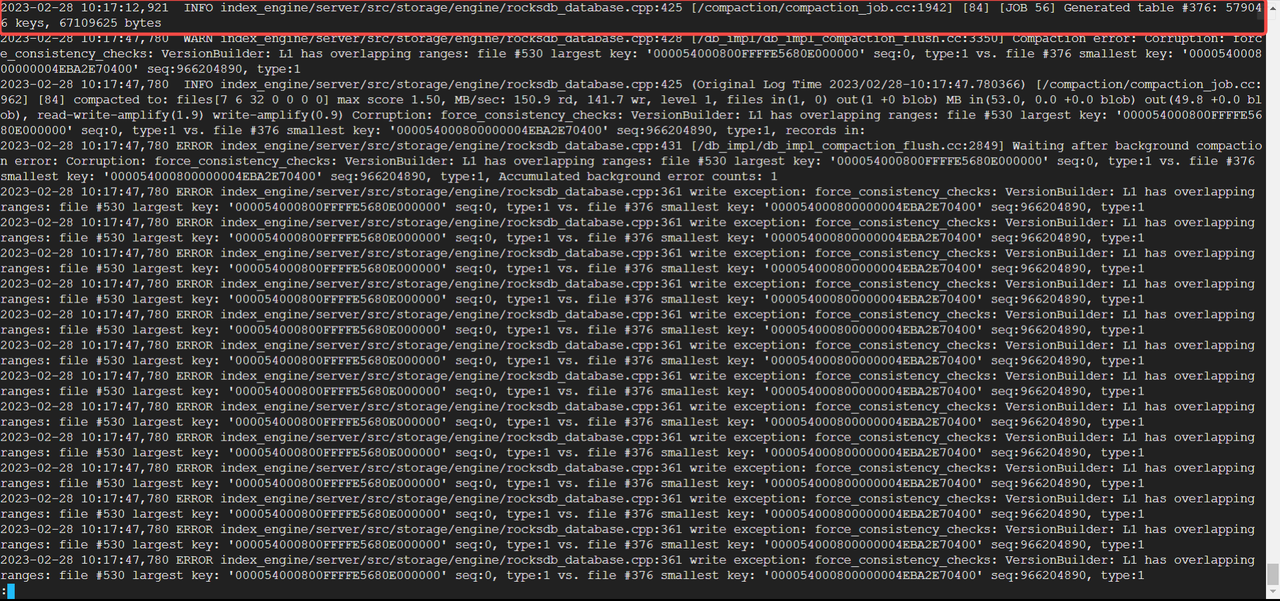 ,新生成的sst,在一致性检查里出现了overlap, 其他报错日志如
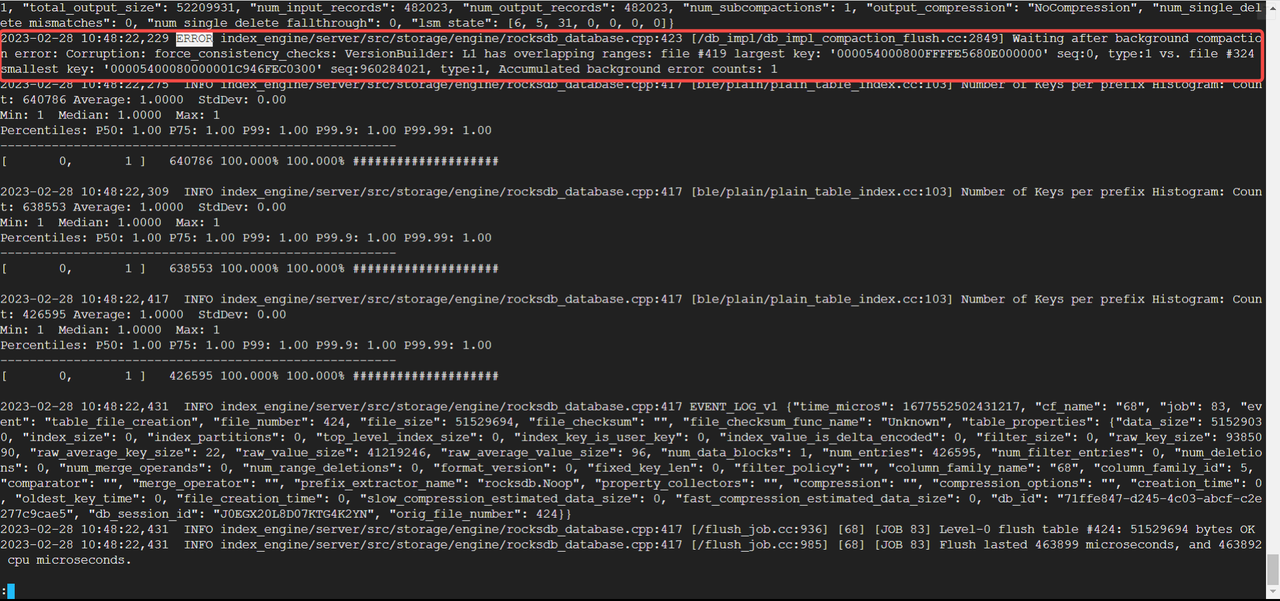 ,
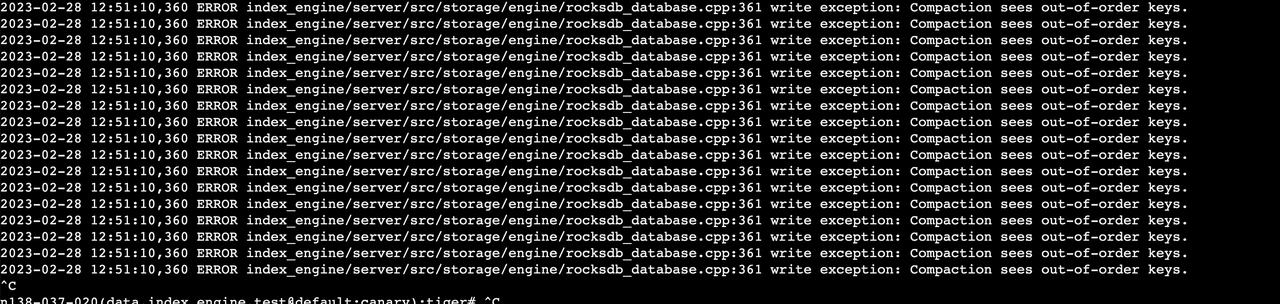 等日志。
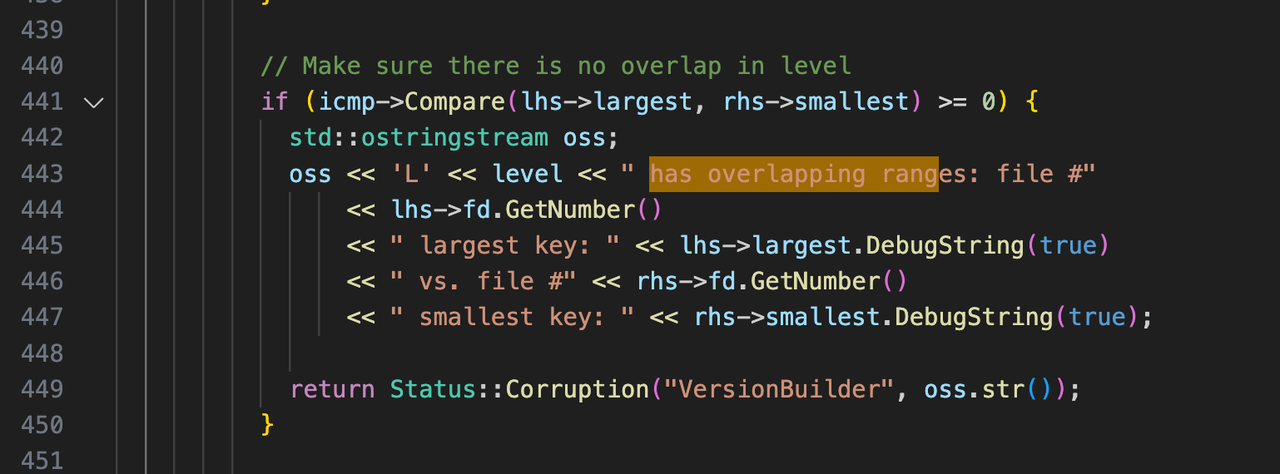 , 在VersionBuilder::Rep::CheckConsistencyDetails,但是这段代码并没有什么意义,只是结果,而不能看到原因,翻看compaction选文件逻辑,从compaction选file时,打印当时的key range,看看有没有出错,
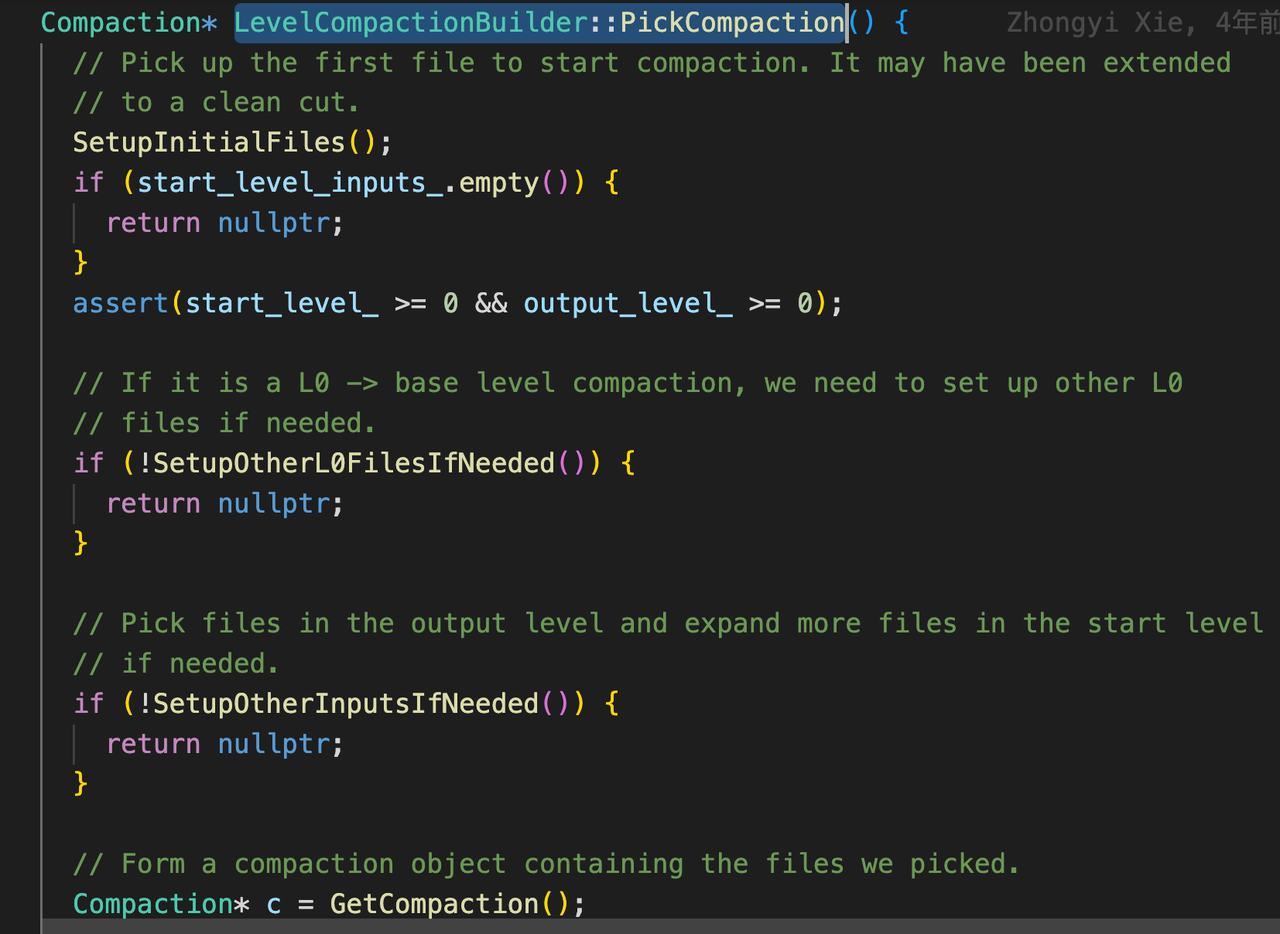 ,
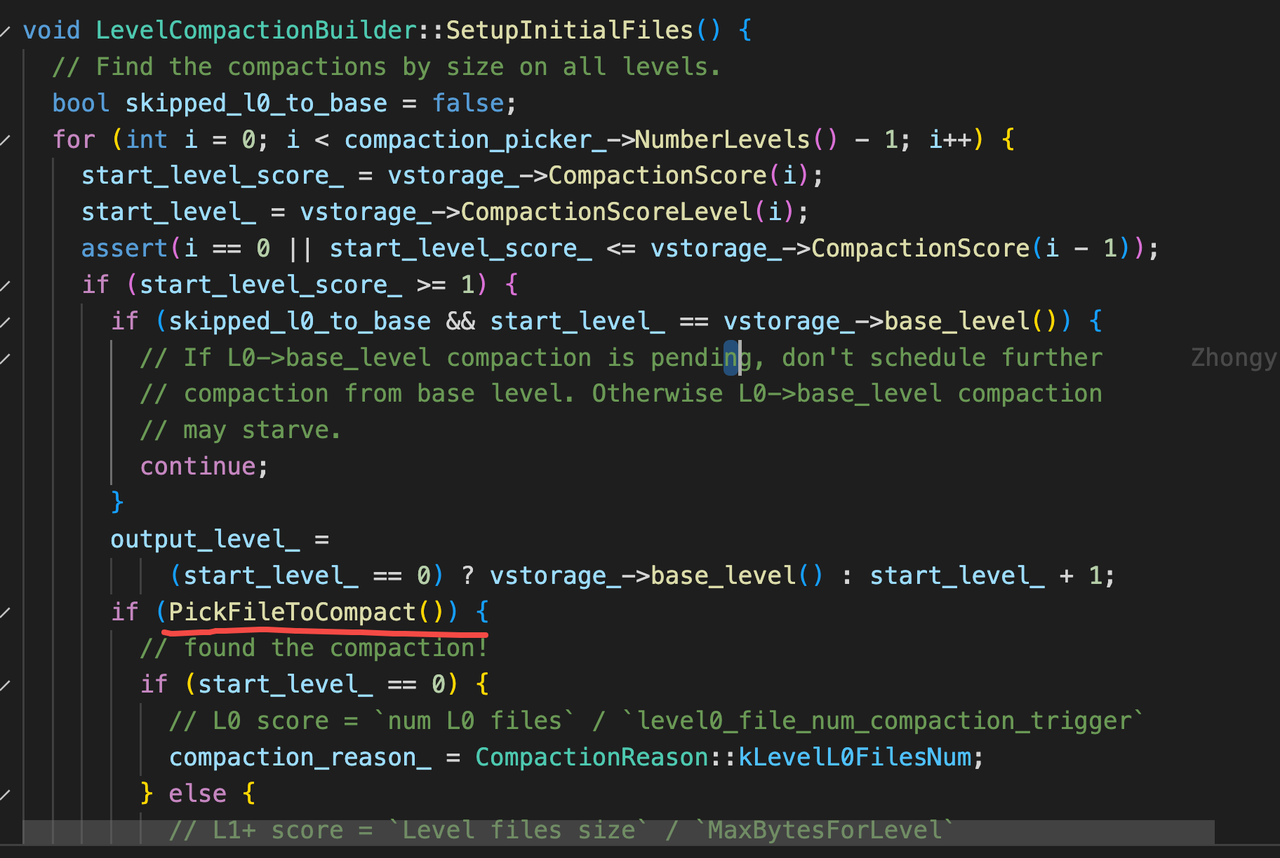
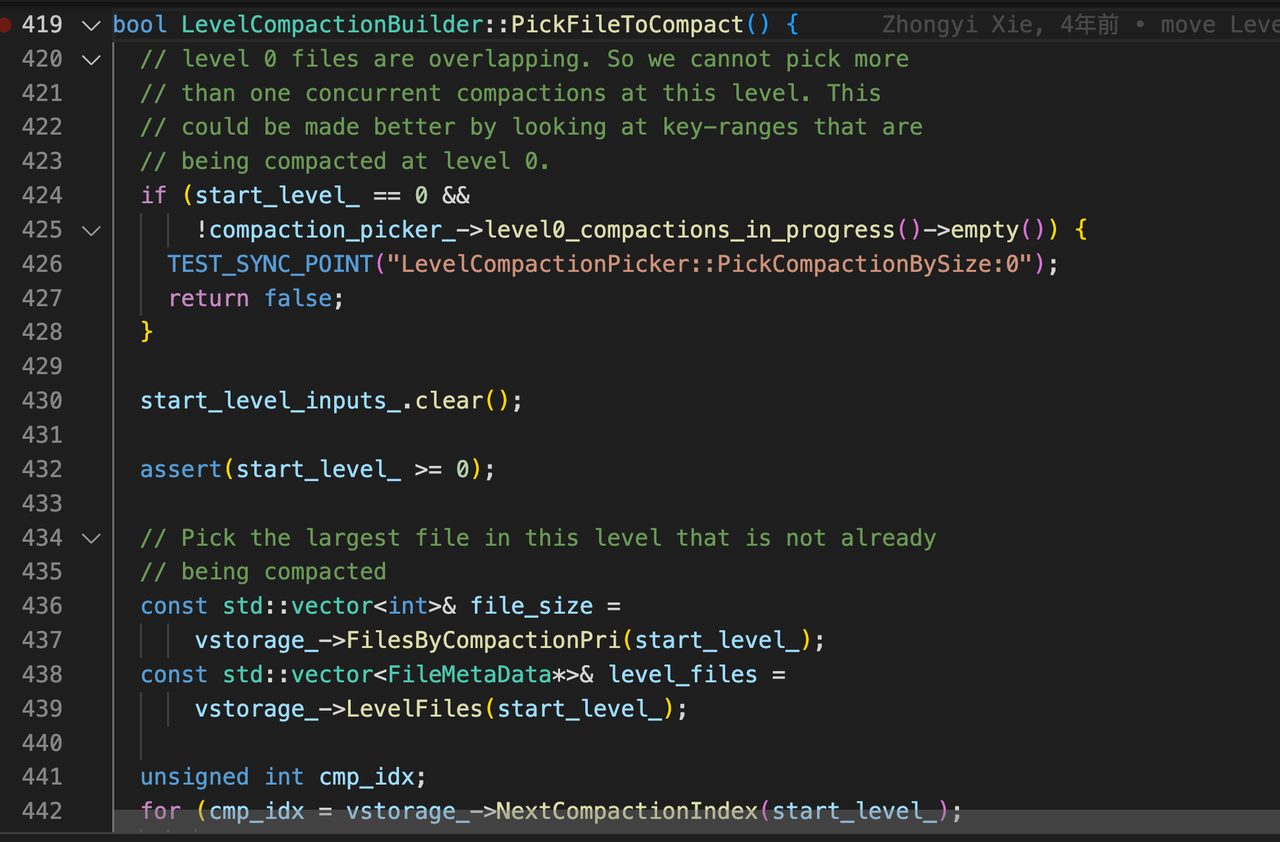
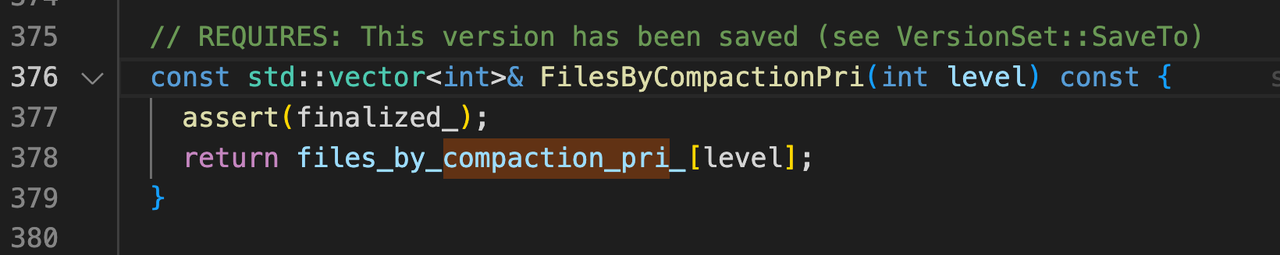
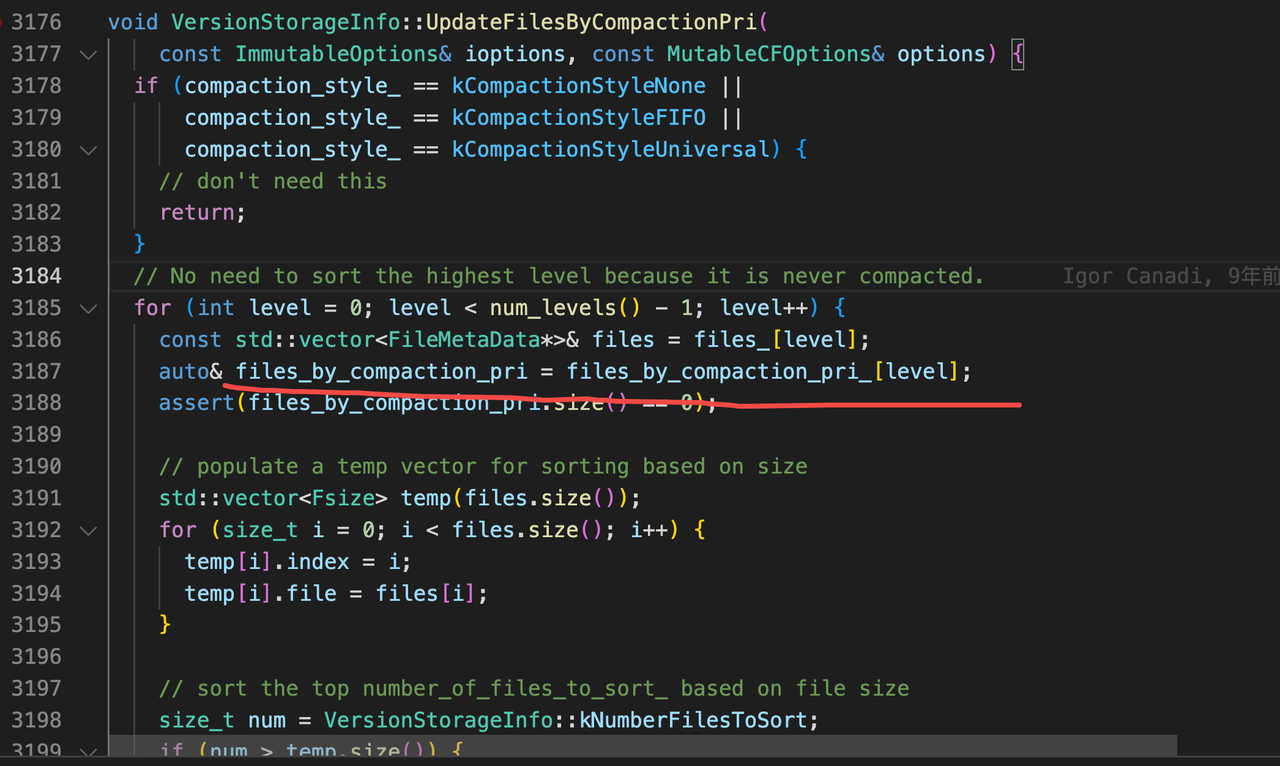 ,这里可以看到files_by_compaction_pri_是个重要变量,
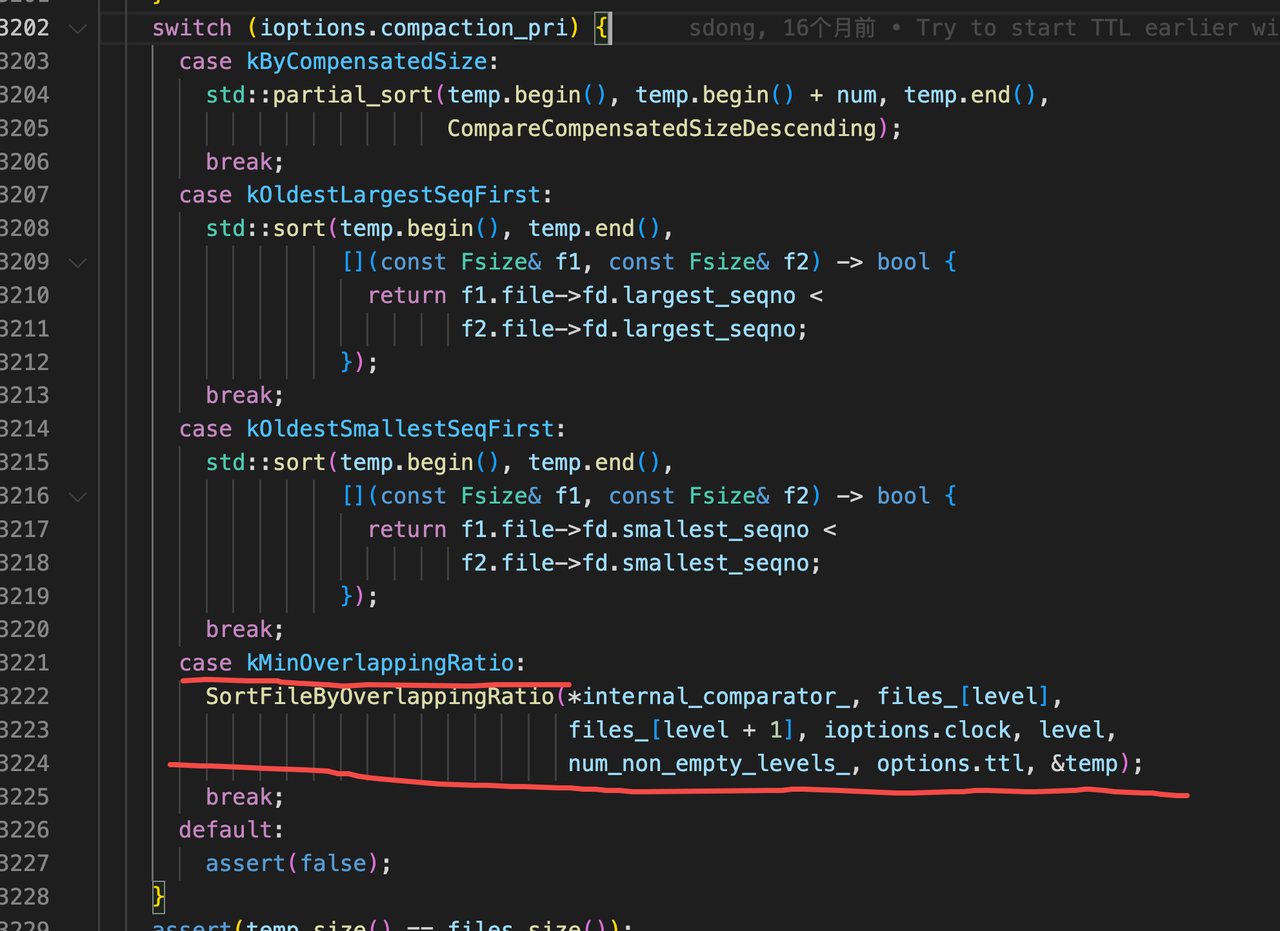 ,
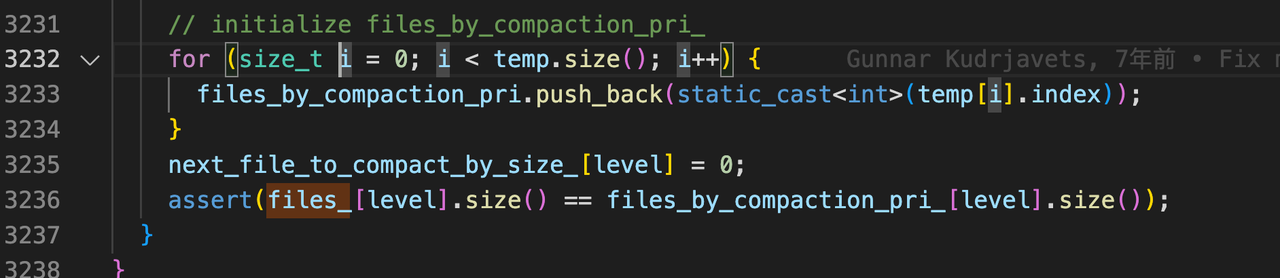 ,temp来自VersionStorageInfo::files_变量,继续看这个变量是如何构造的,并且尽量增加一些日志。
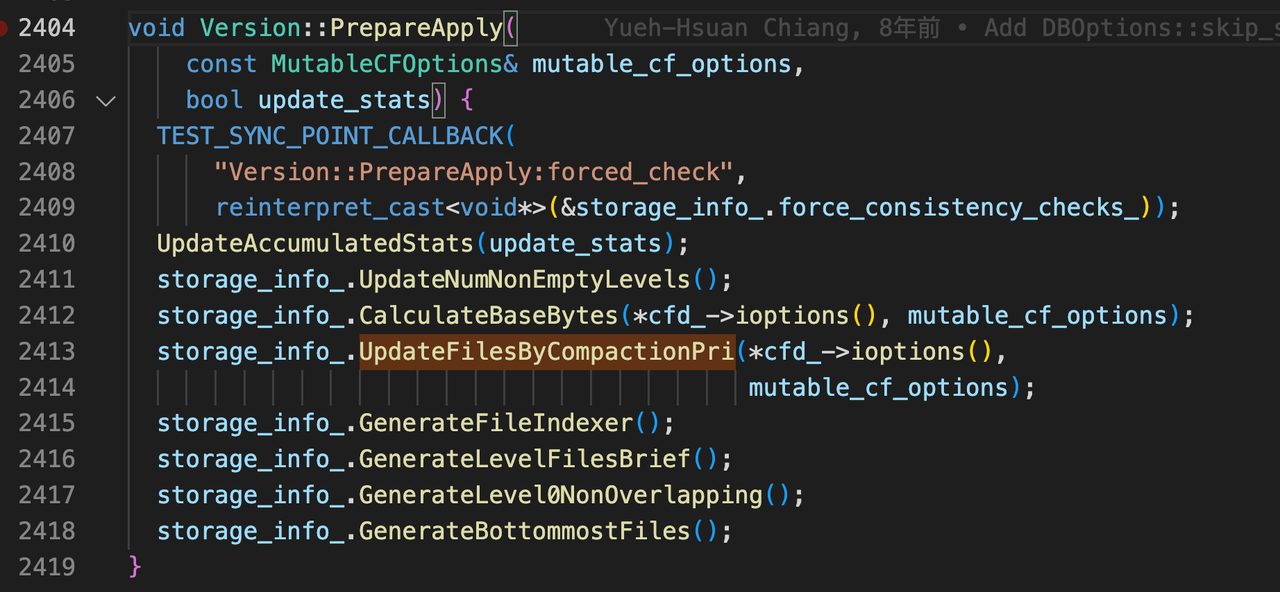
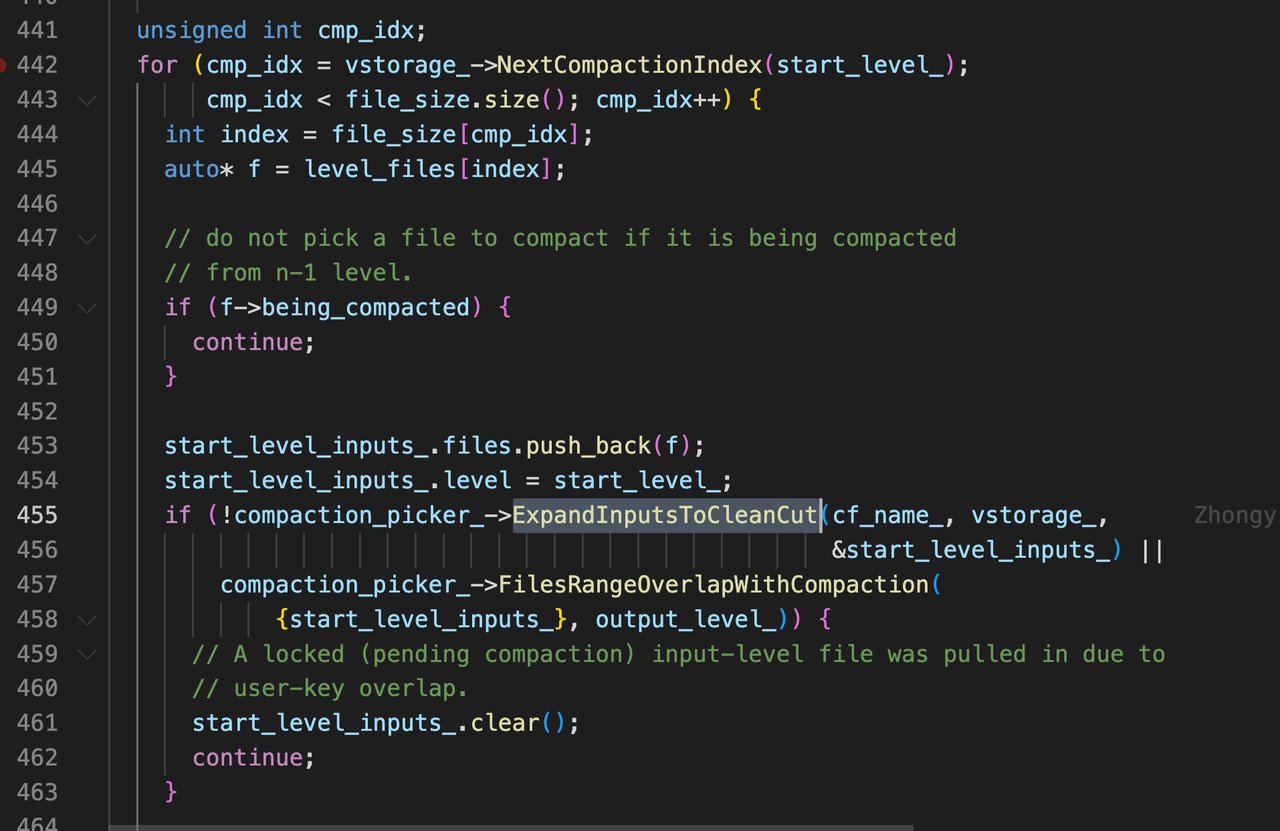 ,
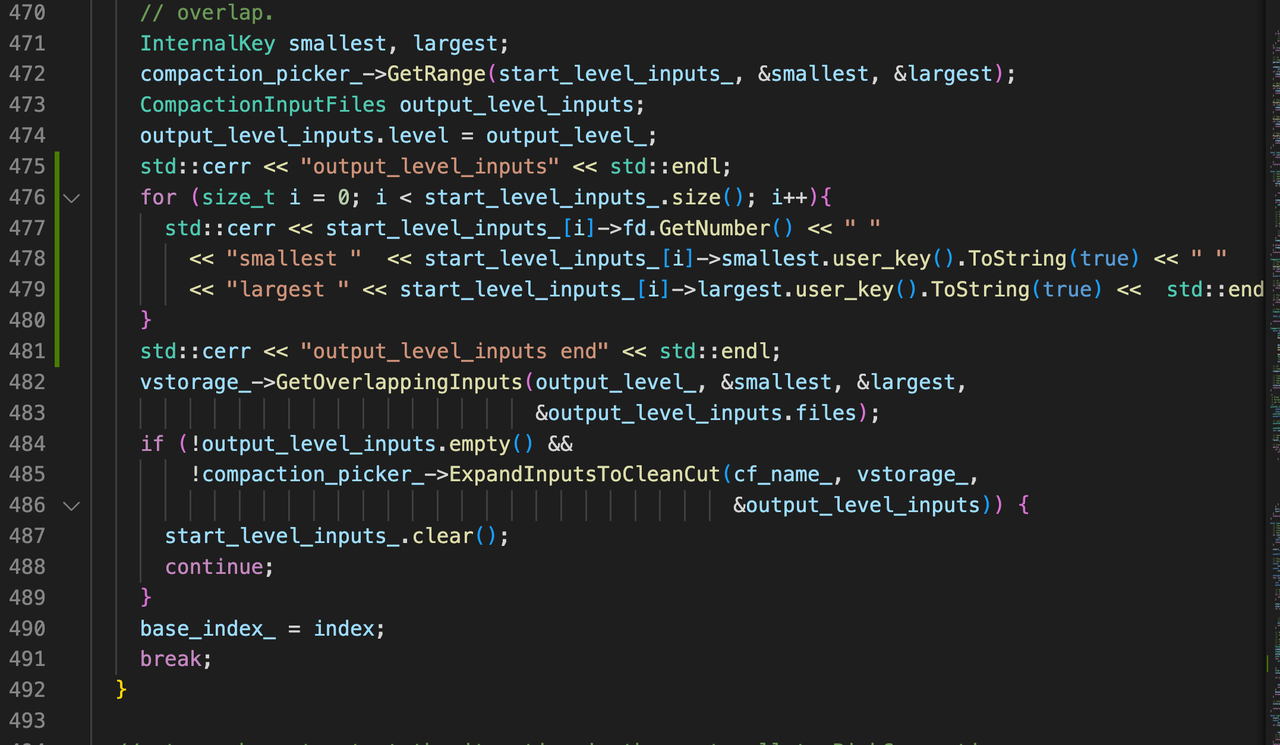 ,
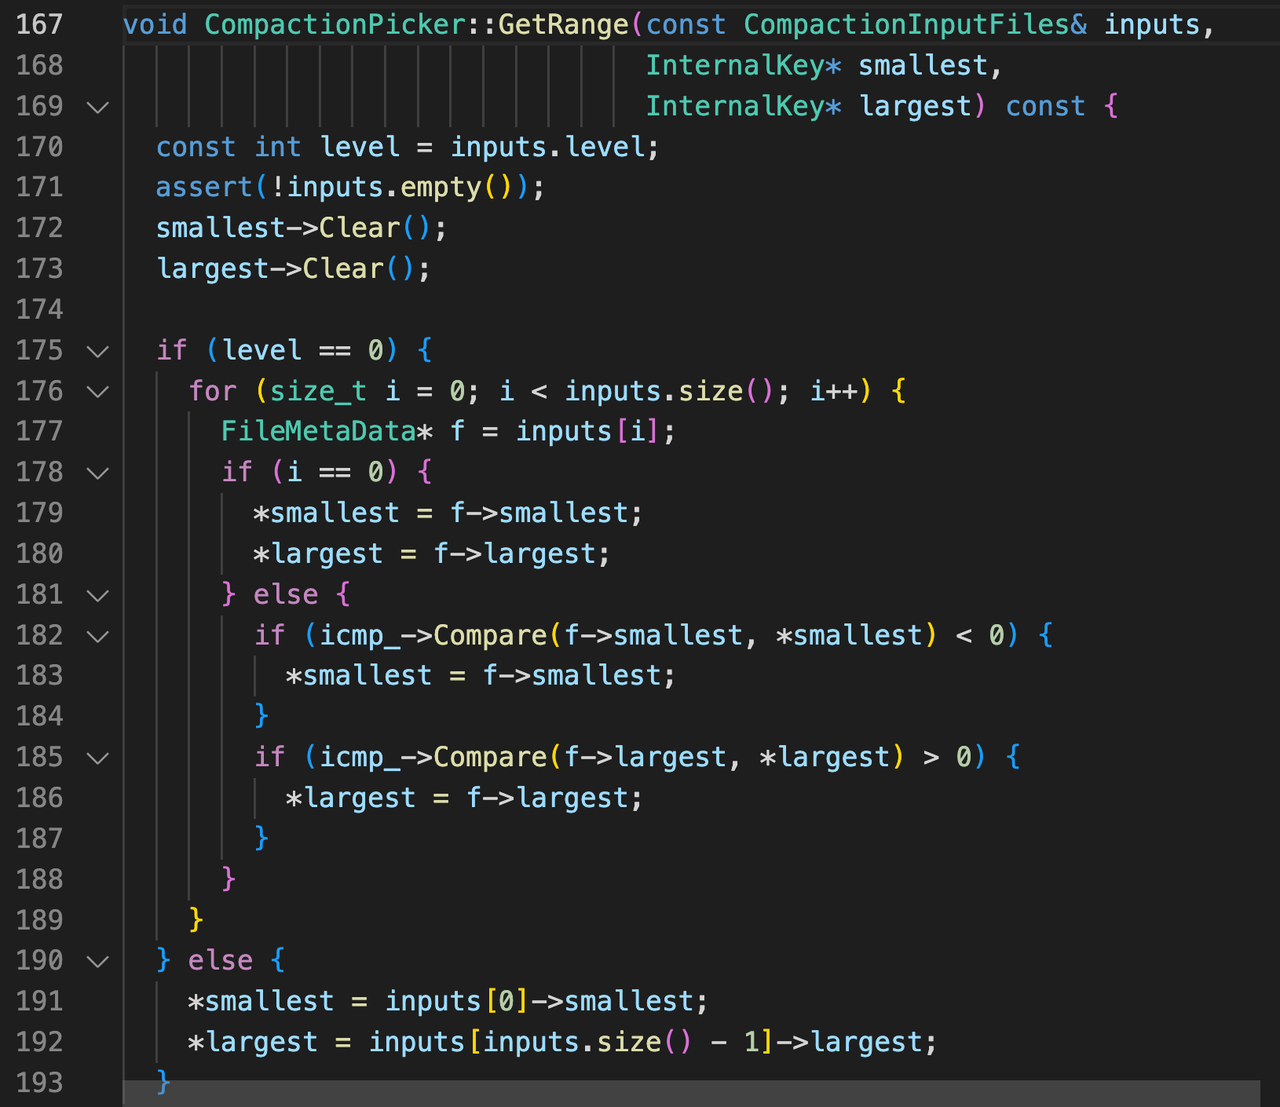
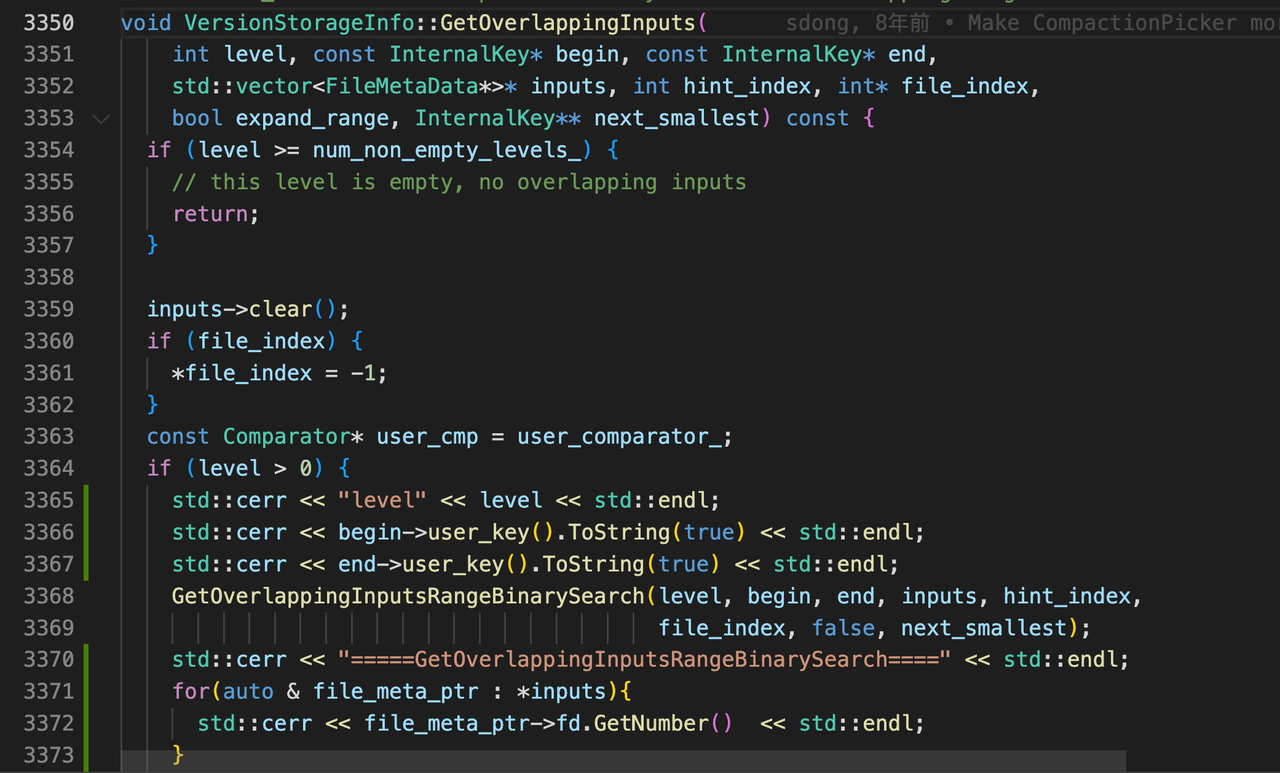
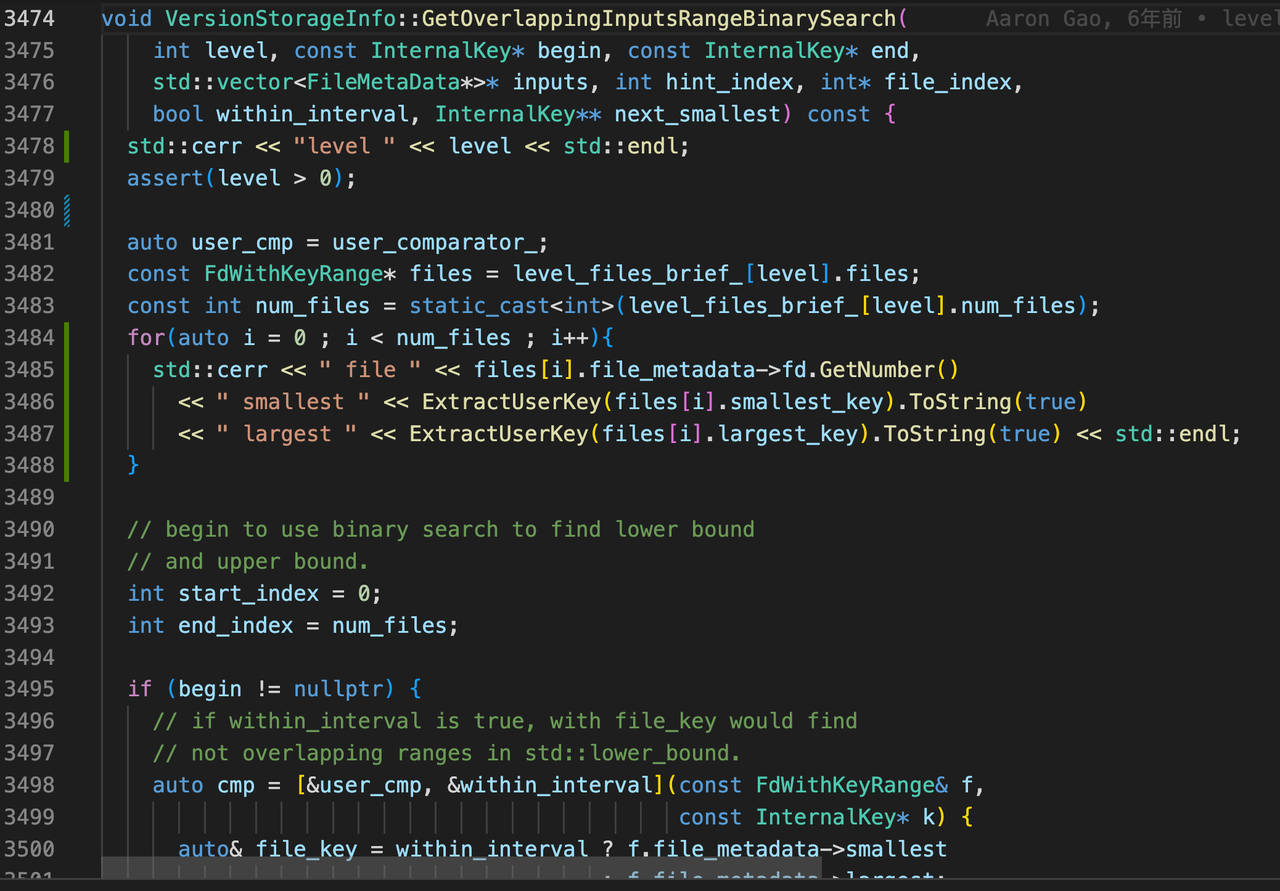
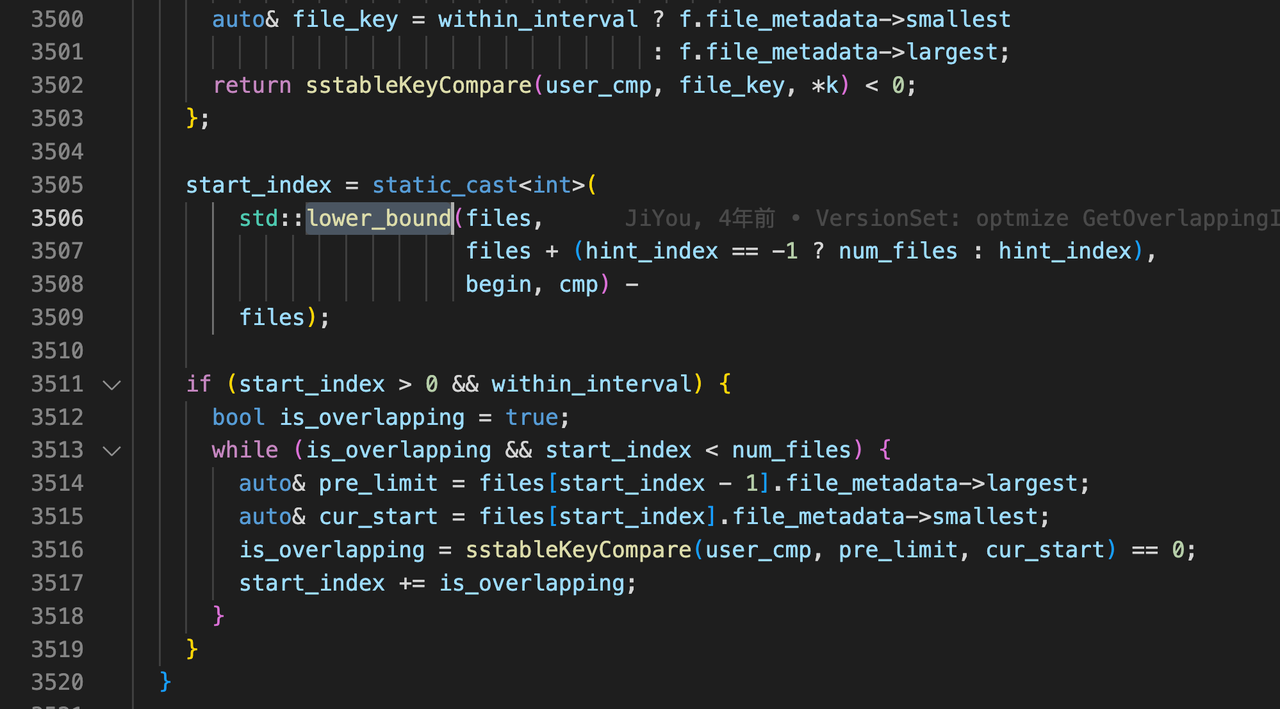
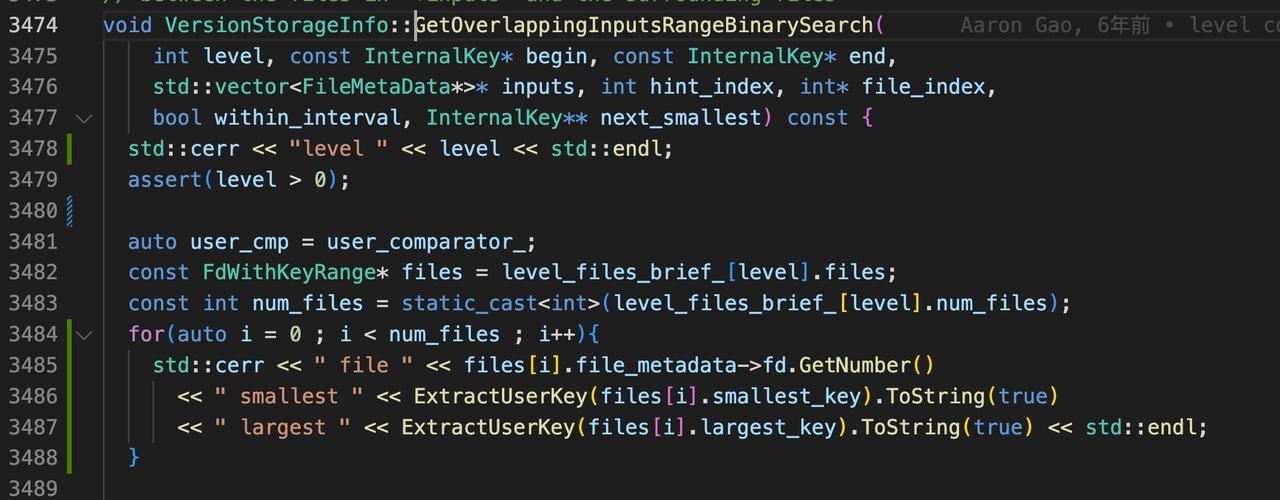 ,至此,基本上能追溯files_的构造过程了,运行,等复现。。。
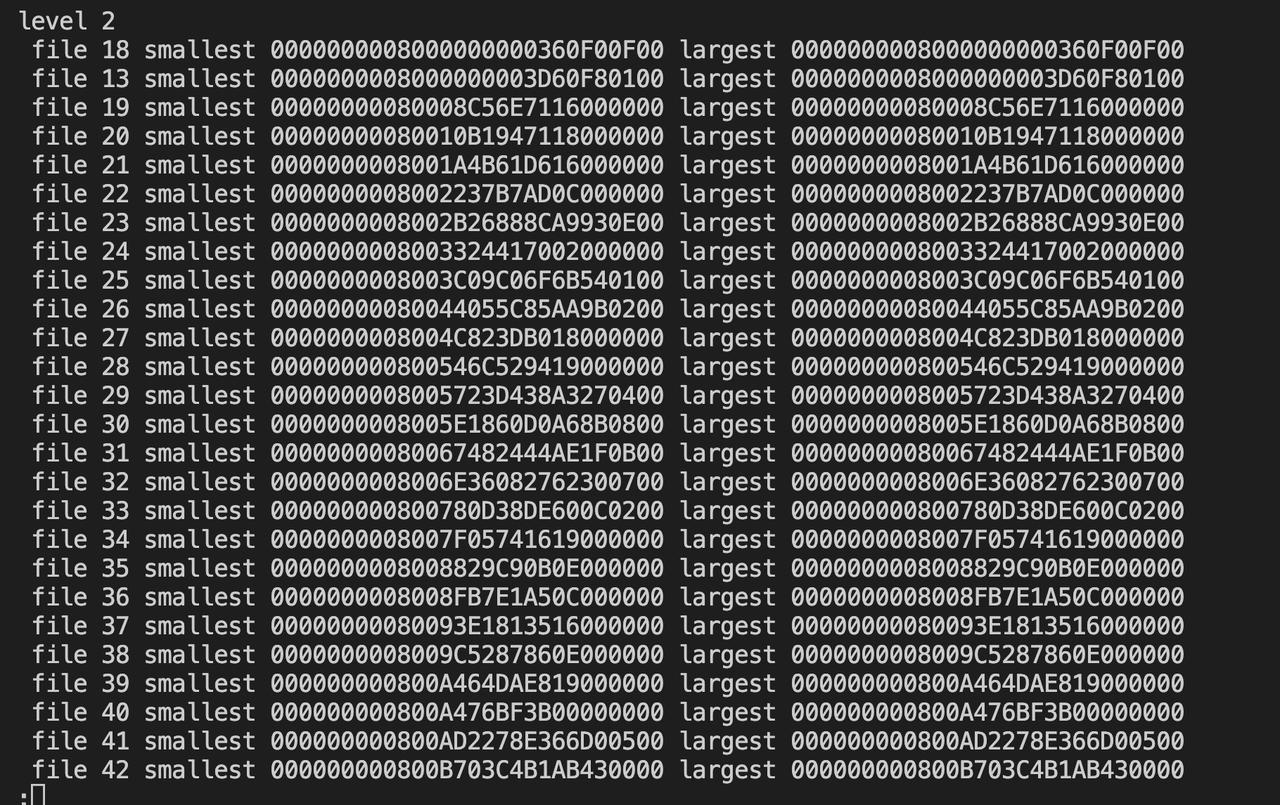 ,为什么version存储信息里大量sst的largest key和smallest key相等?
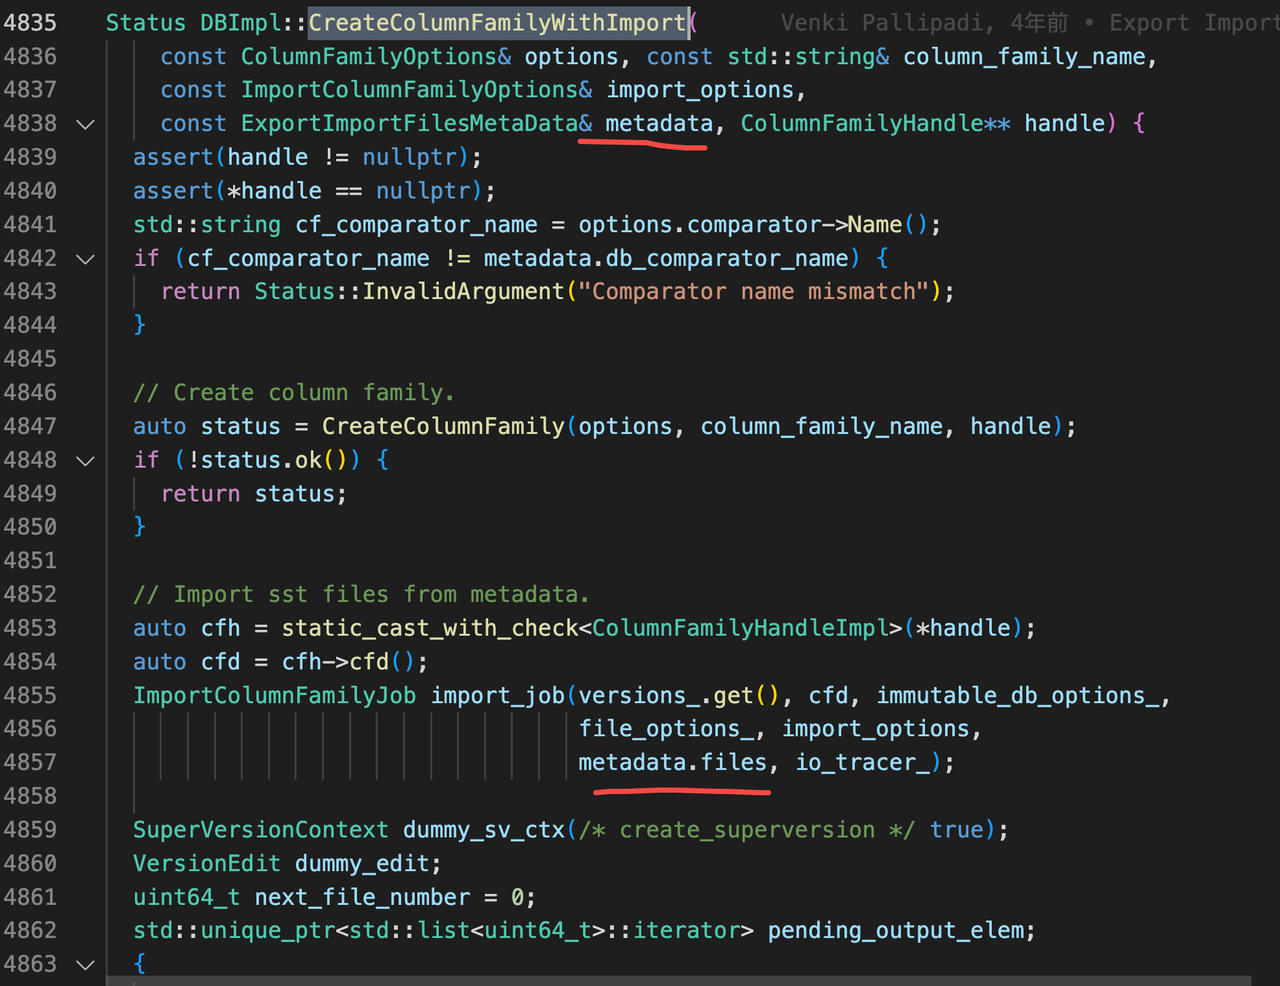 ,
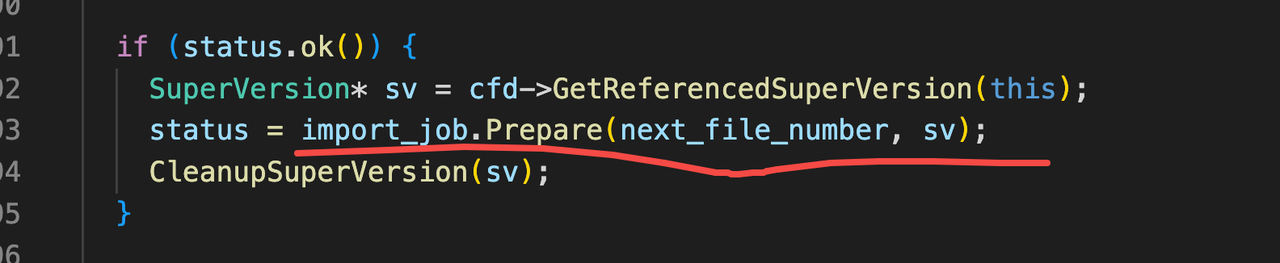 ,
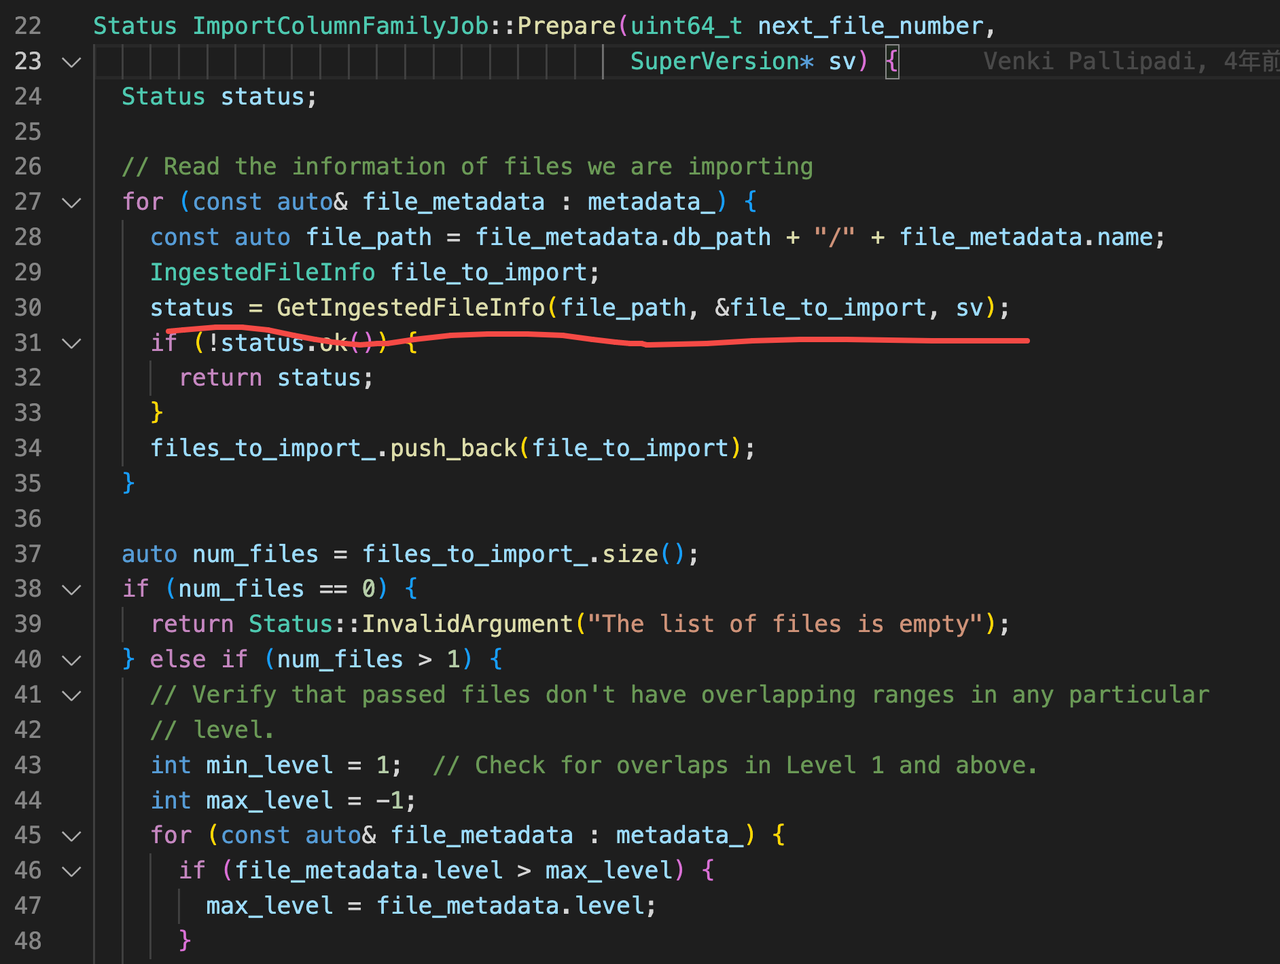
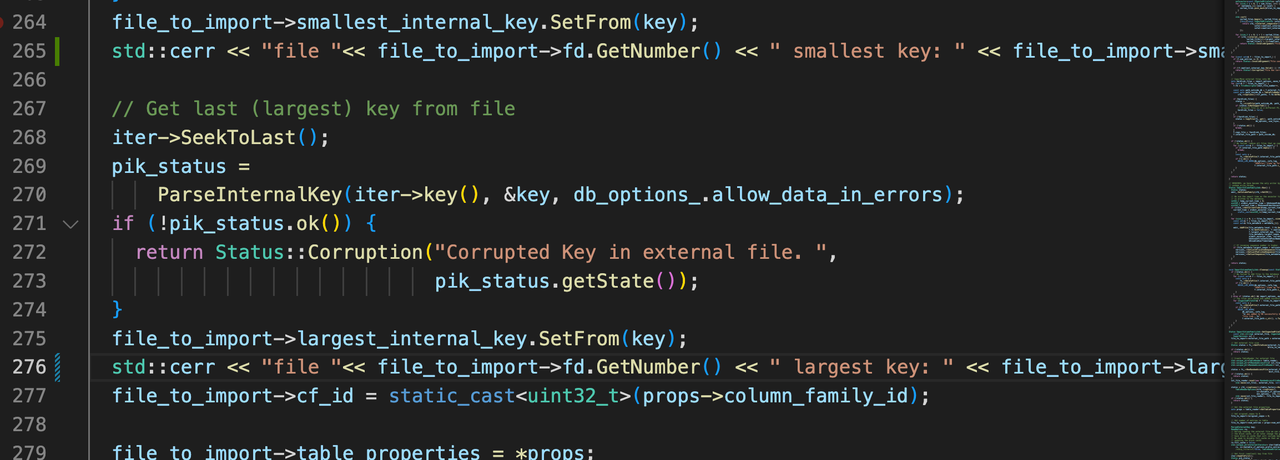 ,